Máquina 01
Janela curta
Três dias formam uma seta. Doze meses podem mostrar que a seta era uma terça-feira comum dentro de uma série sazonal.
Antídoto: série completa, frequência adequada e comparação com o mesmo ciclo anterior.
Ebook Salll · Nº 32 · Decisão e dados
Uma curva detecta mudança. Uma correlação sugere uma relação. A causa só aparece quando existe um contrafactual defensável.

Você joga uma moeda e saem três caras. Em poucos segundos aparecem duas histórias opostas. "Está vindo cara" ou "agora precisa vir coroa". A moeda não ouviu nenhuma delas. Se os lançamentos forem independentes, a próxima jogada continua com a mesma probabilidade.
Um padrão observado é um fato descritivo. Atribuir memória, impulso ou compensação é uma hipótese sobre o mecanismo. Confundir os dois é o primeiro atalho que o dashboard oferece.
No negócio, as moedas ganham nomes mais respeitáveis. Share of search, conversão, preço, ruptura, ranking, ROAS. O gráfico registra o que aconteceu. A sala completa o resto: "foi a campanha", "foi o conteúdo", "o algoritmo gostou", "o shopper reagiu ao preço".
Falk e Konold mostraram que julgamentos de aleatoriedade acompanham a facilidade de codificar uma sequência. Whitson e Galinsky encontraram que a falta de controle pode aumentar a percepção de relações em estímulos não relacionados. É uma base plausível para entender a sala de performance, mas não uma licença para diagnosticar qualquer gestor.
participantes em três estudos sobre produção e julgamento de sequências aleatórias.
Falk & Konold, 1997de falsos positivos em simulação quando quatro graus de liberdade analítica foram combinados.
Simmons et al., 2011foi a concentração média observada em 238 marcas de 22 categorias CPG, não 80/20.
Kim et al., 2017A disponibilidade também pesa. Uma campanha recente, um pico grande e um print compartilhado no grupo vêm à mente com facilidade. Isso pode ocupar o lugar de uma contagem completa. O que é vívido parece mais frequente. O que é recente parece mais explicativo.
Amostra. Uma temporada do Philadelphia 76ers, dois anos de lances livres do Celtics e 26 atletas de Cornell fazendo 100 arremessos cada.
Conclusão original. A crença de atletas e torcedores na mão quente foi tratada como percepção equivocada de sequências aleatórias.
Reanálise. No experimento de Cornell, a diferença média após séries de três passou de 3 para 13 pontos percentuais, p < 0,01.
Lição. O erro não é só ver padrão onde há ruído. Também é rejeitar padrão real porque a régua estatística estava enviesada.
Essa história impede uma conclusão preguiçosa: "todo padrão é apofenia". Há momentos em que três pontos iniciam uma mudança real. O dashboard pode encontrar o sinal. O que ele não pode fazer sozinho é escolher o mecanismo correto.
A pergunta que falta no slide
“O que teria acontecido sem a intervenção?”
Sem essa comparação, o gráfico descreve. Ainda não atribui causa.
Uma narrativa causal pode nascer sem fraude, planilha quebrada ou má intenção. Basta uma escolha aparentemente pequena em cada etapa.
Máquina 01
Três dias formam uma seta. Doze meses podem mostrar que a seta era uma terça-feira comum dentro de uma série sazonal.
Antídoto: série completa, frequência adequada e comparação com o mesmo ciclo anterior.
Máquina 02
A intervenção começa depois do pior resultado. A recuperação natural vira case de sucesso por regressão à média.
Antídoto: pré-período, grupo comparável e medidas repetidas antes da ação.
Máquina 03
Canal, SKU, região, semana, criativo e device criam centenas de chances para um achado acidental parecer especial.
Antídoto: família de testes declarada, FDR quando aplicável e confirmação separada.
Máquina 04
Mídia e venda sobem na mesma semana porque a Black Friday moveu as duas. A correlação recebe o crédito que pertence ao calendário.
Antídoto: tendência, sazonalidade, datas placebo e controle não tratado.
Máquina 05
Ranking gera clique. Clique pode alimentar ranking. Estoque influencia venda. Venda influencia reposição. A seta causal não é única.
Antídoto: desenhar o circuito, medir exposição e procurar variação exógena ou randomizada.
Uma análise de seis anos de compras, cerca de 18 mil lares completos, 238 marcas e 22 categorias de CPG encontrou razão média de 73%, com desvio-padrão de 7 pontos. Detergentes ficaram em 64%. Cigarros, 89%. A concentração existe. O número muda.
O uso correto de Pareto é ordenar contribuições e observar a curva cumulativa real. O uso indevido é desenhar uma linha em 80%, selecionar tudo que cabe antes dela e chamar o recorte de lei.
A maior melhoria de qualidade não exige um modelo novo. Exige impedir que a legenda pule uma etapa.
Estado 01
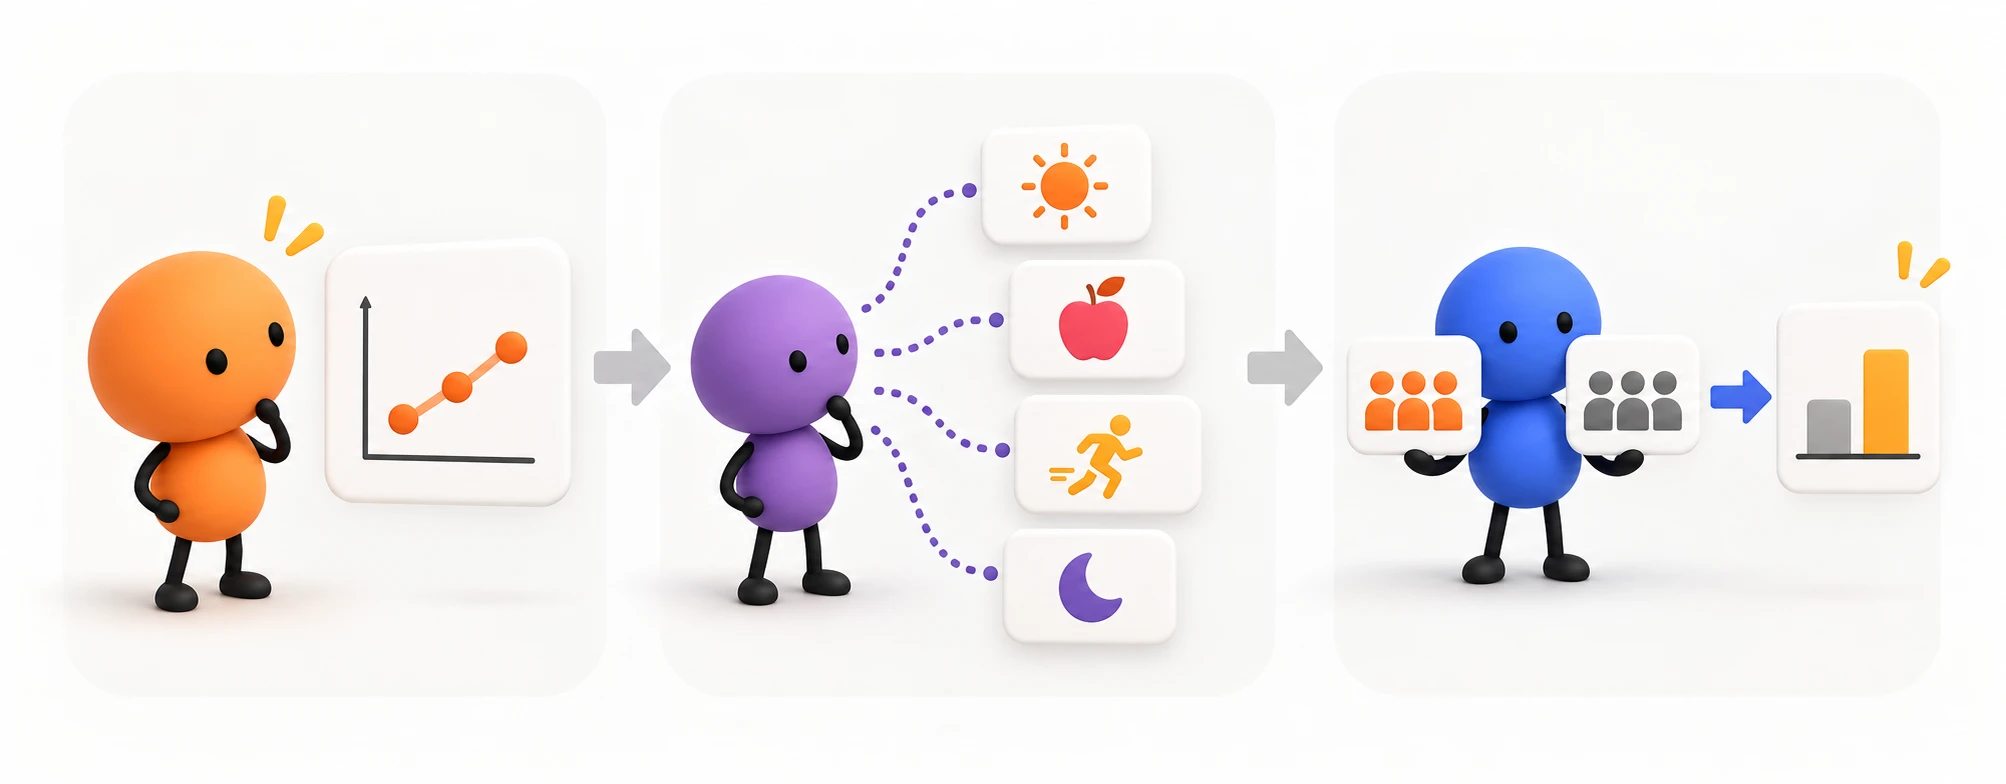
Uma diferença apareceu e merece investigação. Pode ser real, erro de captura, sazonalidade ou ruído.
Diga: “a conversão subiu 8% nesta janela”.
Estado 02
Uma explicação é coerente com o sinal, mas ainda concorre com preço, estoque, mix, mídia e algoritmo.
Diga: “a nova PDP pode ter contribuído”.
Estado 03
Tratamento e contrafactual foram comparados sob um desenho cujas premissas podem ser auditadas.
Diga: “o teste estimou lift de X, com este intervalo”.
Para a mesma campanha, o mesmo SKU e o mesmo período, não conseguimos observar simultaneamente “com ação” e “sem ação”. O trabalho causal é construir uma comparação que aproxime o segundo mundo sem contaminar o primeiro.
Distribui tratamento por sorteio e equilibra, em expectativa, causas observadas e não observadas.
Use quando usuário, sessão, loja, região ou SKU puderem receber tratamentos diferentes sem vazamento.
Compara regiões expostas e não expostas, pareadas por histórico, e estima lift incremental.
Use em retail media e campanhas quando exposição individual não estiver disponível.
Compara a mudança do tratado à mudança do controle. Depende de tendência paralela plausível.
Use quando existir grupo não tratado com histórico comparável e intervenção definida.
Combina unidades não tratadas para reproduzir o histórico do tratado antes da intervenção.
Use em um varejo, região ou marca tratada quando houver bom pool de doadores.
Estima mudança de nível ou tendência depois de uma data, modelando autocorrelação e sazonalidade.
Use quando o timing for nítido e não houver outro choque simultâneo relevante.
Repete a análise em datas ou unidades onde nenhum efeito deveria aparecer.
Use como teste de fragilidade, não como substituto automático de controle.
Em um estudo de campanha do Google, um modelo estrutural estimou 88.400 cliques incrementais, enquanto o experimento randomizado original estimou 84.700. A proximidade foi uma validação útil. Nas regiões não tratadas, o mesmo modelo retornou efeito de 2%, com intervalo de -6% a 10%, um resultado nulo que a narrativa correta precisa preservar.
“A campanha criou demanda de marca.”
Google Trends é amostrado, relativo, normalizado a 0-100 e contém ruído. Compare base total, categoria, PR, concorrência e repetição da coleta.
“A nova PDP converteu melhor.”
Mix de tráfego, device, preço, frete, estoque e composição de clientes. Randomize e confira SRM, MDE e guardrails.
“O desconto gerou o volume.”
Promoção, mídia, posição, concorrente, distribuição e elasticidade heterogênea. O preço costuma ser decidido em resposta à demanda.
“A demanda caiu.”
Venda observada é censurada pelo estoque. Separe indisponibilidade real, produto não encontrado e erro de captura.
“O conteúdo fez o algoritmo subir.”
Posição gera clique e clique pode retroalimentar posição. Ads, buy box, preço e estoque também mudam exposição.
“O ROAS prova retorno incremental.”
Atribuição distribui crédito. Lift estima o que não ocorreria sem mídia. Use holdout, conversion lift ou desenho geo.
Quando o produto fica sem estoque, o funil deixa de observar parte da demanda. O shopper pode procurar, clicar, chegar à PDP e abandonar porque não consegue comprar. Se o dashboard olha apenas pedidos, transforma limitação de oferta em fraqueza de demanda.
O coletor não localizou o SKU, a página ou o dado esperado. Pode ser remoção, URL alterada ou busca sem retorno.
O produto foi encontrado e há sinal verificável de indisponibilidade, sem buy box ou sem opção de compra.
Timeout, CAPTCHA, bloqueio, mudança de DOM, lazy load ou falha de XHR impediram a leitura.
A legenda honesta
“O resultado é compatível com a hipótese.” Não: “o gráfico provou”.
SINAL é uma síntese editorial Salll. Não é escala científica. Serve para obrigar a reunião a atravessar desenho, alternativas e limites antes da conclusão.
Qual janela, frequência, sazonalidade, base e nível de agregação?
O que mudou, quando, para quem e com qual exposição real?
Quem aproxima o contrafactual sem receber spillover?
Preço, estoque, mídia, mix, concorrência e algoritmo foram verificados?
Qual MDE, intervalo, família de testes e regra de parada?
Usuário, sessão, pedido, SKU, loja, termo, região ou dia não são intercambiáveis.
Toda taxa precisa de volume, cobertura e regra de exclusão ao lado.
Ela foi definida antes de olhar o gráfico ou escolhida porque a história ficou melhor?
O achado é o único teste ou o vencedor entre dezenas?
Preço, estoque, calendário, canal, mix, tracking e concorrência precisam entrar na sala.
Quem representa o que teria acontecido sem a ação?
Spillover, mudança de composição e choque estrutural quebram a comparação.
Amostra e duração nascem do MDE, da taxa-base, do alfa e do poder, não de “uma semana”.
Ausência de efeito em controle ou guardrail é parte da evidência, não rodapé.
Registre premissa, prazo de revisão e condição de reversão.
Dados de negócio precisam gerar decisão. Mas decisão não exige fingir que observação é causa. Uma equipe madura age em camadas: reage ao risco operacional, testa a hipótese e atualiza a crença quando o contrafactual chega.
Marque cada conclusão como sinal, hipótese ou prova. A linguagem passa a carregar a incerteza do desenho.
Uma boa narrativa inclui as explicações que perderam e diz por que perderam.
Controles sem efeito, guardrails estáveis e replicações fracas calibram a história.
Defina o próximo teste, a condição de parada e o sinal que mudará o rumo.
Esta revisão combina psicologia da aleatoriedade, estatística, séries temporais, mensuração publicitária e documentação de plataformas. Ela não estima uma taxa universal de erro em dashboards.
Estudos laboratoriais explicam mecanismos, não magnitude em negócio. Estudos de publicidade e CPG têm contexto, período e infraestrutura específicos. Efeitos numéricos não devem virar benchmark.
Foram preservados: p = 0,09 na percepção de imagens inexistentes de Whitson e Galinsky; ausência de interação por foco do cenário, p = 0,98; controle não tratado em Brodersen et al., 2%, intervalo de -6% a 10%; baixa sensibilidade a efeitos de 1% nas simulações.
Randomização continua sendo a comparação mais direta quando viável. Métodos observacionais podem estimar efeitos quando suas premissas são plausíveis e auditadas. Nenhum modelo compensa controle contaminado ou choque não medido por decreto.
Amostras, métodos, efeitos, contrapontos e limitações estão detalhados no dossiê de pesquisa deste tema. Data de corte: 2026-09-30.